fact-check-x-complete
面向真实业务决策的多平台事实核验 Skill。正式支持深知晓、深知晓(深度溯源)、豆包、腾讯元宝、DeepSeek 和通义千问,按用户输入动态选择 N≥1 个平台。完整采集原回答、引用、截图与页面存证,结构化比较关键事实,按需使用可信搜索逐点核验权威证据,并评估各平台表现。权威答案是核验产物之一,原始证据、冲突与证据…
Skill by ASI2030
Chalk Labs
Need help deploying fact-check-x-complete?
Chalk Labs sets up agents like this inside real teams: connected to your tools, tested on your data, with a human in the loop where it matters.
Install
Works with Claude Code, Claude apps, Codex, Cursor, Gemini CLI, GitHub Copilot, VS Code, OpenCode, Goose, Windsurf. Read the repository before you give any tool access to your data.
npx agentmarket install skill/asi2030-fact-check-x-complete
Asks which of your tools to add it to (Claude Code, Codex, Cursor, VS Code, Windsurf, Gemini CLI, Claude Desktop) and shows the change first. See https://agentmart.dev/cli.
Get the weekly diff
The weekly diff: one email a week with new agent tools, notable updates and grade changes, plus security alerts for tools you follow. Double opt-in, one-click unsubscribe.
About
Use cases: backend, agent-building
Reviews
Write a reviewNo reviews yet. Installed it? Reviews come from verified installers only. How reviews work
Permissions
What this skill can do and what it asks for, from its SKILL.md and code. Checked Oct 26, 2026.
- Tools
- No tools found
- Secrets
- None asked for
- Install scripts
- None found
- Runs as
- Python package
Network hosts it talks to 3
codeload.github.com· found in install commandopen.dknowc.cn· found in codeplatform.dknowc.cn· found in code
Files it touches
~/.claude/skills/fact-check-x-complete/etc/ssl/cert.pem/opt/homebrew/etc/openssl@3/cert.pem/tmp/fact-check-x-platform-analysis.json/tmp/fc_result.json/usr/local/etc/openssl@3/cert.pem- Your home directory (~)
What's inside
- Skill name
fact-check-x-complete- Description
- 面向真实业务决策的多平台事实核验 Skill。正式支持深知晓、深知晓(深度溯源)、豆包、腾讯元宝、DeepSeek 和通义千问,按用户输入动态选择 N≥1 个平台。完整采集原回答、引用、截图与页面存证,结构化比较关键事实,按需使用可信搜索逐点核验权威证据,并评估各平台表现。权威答案是核验产物之一,原始证据、冲突与证据边界全程可追溯。基础采集与对比无需 API Key;可信搜索是权威核验阶段的可选增强。语义工作由 Codex、Claude Code、WorkBuddy 等当前运行载体完成,不调用外部大模型 API。
- License
- Apache-2.0
- Metadata
- slug: fact-check-x · summary: 支持 6 个 AI 平台的完整采集、结构化对比、权威核验、答案生成与平台表现评估。 · version: 1.1.25 · homepage: https://github.com/ASI2030/Fact-Check-X · displayName: 全知晓(Fact-Check-X)
- Instructions
- 381 lines in SKILL.md · view on GitHub
Before installing
- Ships executable scripts
Files (128)
- LICENSE
- NOTICE
- PRIVACY.md
- SECURITY.md
- SKILL.md
- THIRD_PARTY_NOTICES.md
- TRADEMARKS.md
- openai.yaml · agents/
- SKILL.md · modules/fact-check-x-authoritative-verify/
- acceptance-criteria.md · modules/fact-check-x-authoritative-verify/references/
- contracts.md · modules/fact-check-x-authoritative-verify/references/
- final-report-baseline.html · modules/fact-check-x-authoritative-verify/references/
- authority_verify.py · modules/fact-check-x-authoritative-verify/scripts/
- batch_search.py · modules/fact-check-x-authoritative-verify/scripts/
- common.py · modules/fact-check-x-authoritative-verify/scripts/
- participants.json · modules/fact-check-x-authoritative-verify/scripts/platform/
- policy_match.py · modules/fact-check-x-authoritative-verify/scripts/
- render_authority_report.py · modules/fact-check-x-authoritative-verify/scripts/
- render_final_report.py · modules/fact-check-x-authoritative-verify/scripts/
- render_platform_report.py · modules/fact-check-x-authoritative-verify/scripts/
- anchor_conflict_test.py · modules/fact-check-x-authoritative-verify/tests/
- dknow_authority_contract_test.py · modules/fact-check-x-authoritative-verify/tests/
- K1-assessment.json · modules/fact-check-x-authoritative-verify/tests/fixtures/
- K1-request.json · modules/fact-check-x-authoritative-verify/tests/fixtures/
- K2-assessment.json · modules/fact-check-x-authoritative-verify/tests/fixtures/
- K2-evidence-fixture.json · modules/fact-check-x-authoritative-verify/tests/fixtures/
- K2-request.json · modules/fact-check-x-authoritative-verify/tests/fixtures/
- geography_test.py · modules/fact-check-x-authoritative-verify/tests/
- metrics_denominator_test.py · modules/fact-check-x-authoritative-verify/tests/
- model_judgment_test.py · modules/fact-check-x-authoritative-verify/tests/
- policy_equivalence_test.py · modules/fact-check-x-authoritative-verify/tests/
- smoke_test.py · modules/fact-check-x-authoritative-verify/tests/
- SKILL.md · modules/fact-check-x-knowledge-compare/
- acceptance-criteria.md · modules/fact-check-x-knowledge-compare/references/
- contracts.md · modules/fact-check-x-knowledge-compare/references/
- common.py · modules/fact-check-x-knowledge-compare/scripts/
- knowledge_compare.py · modules/fact-check-x-knowledge-compare/scripts/
- policy_match.py · modules/fact-check-x-knowledge-compare/scripts/
- render_comparison.py · modules/fact-check-x-knowledge-compare/scripts/
- citation_presence_test.py · modules/fact-check-x-knowledge-compare/tests/
- deepseek_reference_faithfulness_test.py · modules/fact-check-x-knowledge-compare/tests/
- comparison-analysis.json · modules/fact-check-x-knowledge-compare/tests/fixtures/
- results.json · modules/fact-check-x-knowledge-compare/tests/fixtures/
- model_judgment_test.py · modules/fact-check-x-knowledge-compare/tests/
- requirements_scope_test.py · modules/fact-check-x-knowledge-compare/tests/
- smoke_test.py · modules/fact-check-x-knowledge-compare/tests/
- LICENSE · modules/llm-answer-reference-compare/assets/tool/
- auth-state.js · modules/llm-answer-reference-compare/assets/tool/dist/capture/
- browser-session.js · modules/llm-answer-reference-compare/assets/tool/dist/capture/
- generic-chat.js · modules/llm-answer-reference-compare/assets/tool/dist/capture/
- login-recovery.js · modules/llm-answer-reference-compare/assets/tool/dist/capture/
- platform-registry.js · modules/llm-answer-reference-compare/assets/tool/dist/capture/
- dknowc-chat.js · modules/llm-answer-reference-compare/assets/tool/dist/capture/providers/
- resume.js · modules/llm-answer-reference-compare/assets/tool/dist/capture/
- selector-recovery.js · modules/llm-answer-reference-compare/assets/tool/dist/capture/
- cli.js · modules/llm-answer-reference-compare/assets/tool/dist/
- report-cli.js · modules/llm-answer-reference-compare/assets/tool/dist/
- html-report.js · modules/llm-answer-reference-compare/assets/tool/dist/report/
- markdown-report.js · modules/llm-answer-reference-compare/assets/tool/dist/report/
- reference-matrix.js · modules/llm-answer-reference-compare/assets/tool/dist/report/
- …and 68 more
SKILL.md (first lines)
# 全知晓(Fact-Check-X) 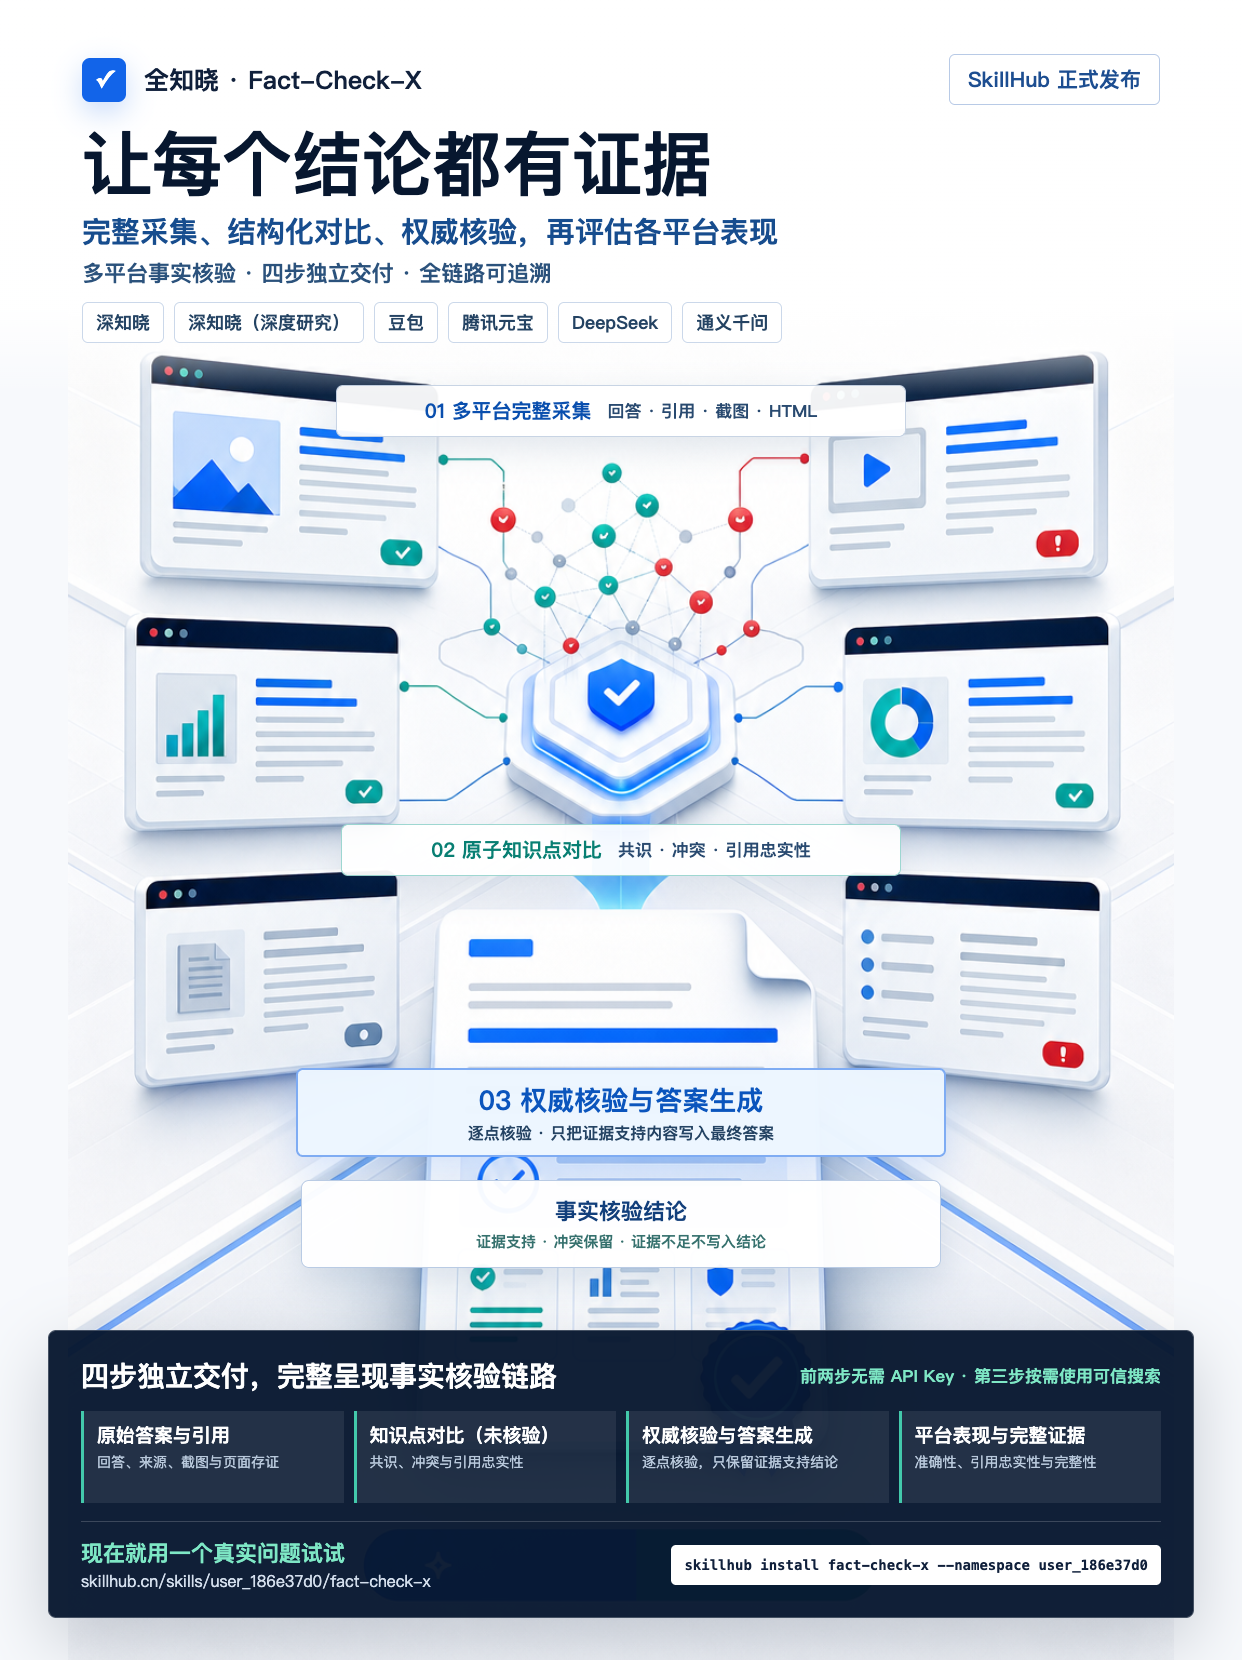 把同一个问题交给一个或多个 AI 平台,完整保留每家的回答和引用,再把关键事实逐点对齐、核验并评估各平台表现。第三步会基于权威证据生成最终答案,但不会用“答案生成”代替完整事实核验:证据冲突会被保留,官方无法查证的内容统一标为“疑似误导”,移入补充参考风险区且不写入确定结论。用户只需说出问题和要比较的平台,不需要学习平台 ID、内部流程编号或报告术语。 ## 支持平台 当前内置以下网页端平台,按用户本次输入动态选择任意 `N≥1` 个: | 平台 | 能力 | |---|---| | 深知晓 | 标准问答、引用与官方来源采集 | | 深知晓(深度溯源) | 等待普通回答完成后在同一会话启动深度溯源,并作为独立结果采集 | | 豆包 | 回答、引用与页面存证 | | DeepSeek | 回答、引用、逐条来源正文与页面存证 | | 通义千问 | 回答、引用、逐条来源正文与页面存证 | | 腾讯元宝 | 回答、引用、逐条来源正文与页面存证 | 平台由用户选择,不存在固定“五平台模式”。`N=1` 可完成单平台事实核验;`N≥2` 会额外比较各平台的共识、冲突和来源差异。网页结构变化时,技能会明确报告失败并停在当前阶段,不会用部分结果冒充完整报告。 ## 使用体验 - 用户只需提供核验问题和想比较的平台;没有指定平台时,立即列出“深知晓、深知晓(深度溯源)、豆包、DeepSeek、通义千问、腾讯元宝”供用户选择,不得漏掉深度溯源,也不要求用户记平台 ID。 - 第一次使用某个平台时打开浏览器,由用户本人完成登录或验证码;会话保存后自动复用。 - 每一步都交付可打开的独立报告:各方答案汇总、各方答案聚合(未核验)、权威核验后的最终答案、各方答案测评报告。 - 每份阶段报告展示后都必须等待用户明确选择继续、修正或结束;最初要求完整执行不能替代逐阶段确认。 - 第二步在概览和逐知识点明细中分别展示直接答案与补充参考;第三步只保留权威最终答案;第四步以一个锁定明细区承接第三步结果并分区测评。 - 第三步只展示最终答案、权威证据和证据边界;第四步只消费已锁定的第三步数据,负责平台裁决、指标与表现对比,不重算第三步。 - 第四步覆盖率只衡量“答没答到”:答到即算覆盖,证据是否充分由证据充分率单独体现。仅当一个知识点在所有平台中都是未回答或证据不足时,才整体移出覆盖率与准确率分母。 - “编造式幻觉”和“证据不足”只作为内部原始裁决状态保留;对用户统一显示为“疑似误导”,移入补充参考风险区并在报告上方突出。每个知识点的长依据默认收起,点击后可看完整原文。 - 来源采集、可信搜索等技术动作失败时原则上停止;若流程仍继续,每一步报告都必须在显著位置提示技术失败及影响,相关主张继续按“疑似误导”呈现。 - 原答案的引用存在性与来源支持性独立保留。`attachedReferenceIndexes` 为当前摘录观察到的引用,`citedReferenceIndexes` 为校验采用的证据;抓取失败或不支持不能写成“平台未附依据”。跨句、跨表格行的引用必须回到对应主张检查,不得借用邻行脚标。 - 拆解主张时保留年度、政策项目、适用对象与条件。历史公示不能省略年度改写为现行政策;不同项目的金额不得直接当作同一事实冲突。金额必须与单位匹配,年份、备案号不能充当金额证据。 - 多平台采集与知识点对比不需要 API Key。只有用户继续进行权威证据核验,且现有材料不足以直接裁决时,才检查可信搜索配置。 - 可信搜索未配置时,只引导用户登录深知智能平台;技能自动获取或创建专用 Key 并安全保存在本机,不要求用户复制粘贴密钥。 - 语义分析由 Codex、Claude Code、WorkBuddy 等当前运行载体完成,不调用外部大模型 API。 ## 强制执行门禁(任何动作前先读) 1. **语言硬门禁**:读取本技能后的第一句话、过程更新、命令说明、阶段检查点、错误说明和最终答复全部只使用简体中文;不得输出英文句子。命令、路径、平台 ID 和数据字段名可以保留原文。第一条回复直接使用“我会核验这个问题:先采集您选择的平台原回答和引用,再比较共识与分歧;如需权威结论,最后用可信搜索逐点核验。每一步都会给您一份可打开的报告。”,不得先用英文介绍技能或内部流程编号。 2. 执行任何命令前先检查当前会话可调用的工具。完整在线采集优先由包内 Playwright 直接启动并控制系统 Chrome、Microsoft Edge、Brave 或 Chromium;Computer Use 不是正常采集的前置条件。页面结构变化时先运行选择器恢复与验证层;当前载体自带的浏览器或 Computer Use 是首选诊断手段,`agent-browser` 只可作为失败后的可选诊断工具,不是依赖,也不得直接交付答案或改写适配器。只有命令工具时可以前台执行一次 `login` 验证可见浏览器,但没有真实成功输出前不得声称浏览器已启动。 3. 所有流水线命令必须前台直接执行并等待真实退出状态,包括 `login`、`run`、`prepare-comparison`、`complete-comparison`、`prepare-authority`、`search-authority`、`finalize-authority`、`reopen-authority` 和 `deliver`。执行工具因等待用户操作而返回可轮询的运行会话 ID 时,应保留并轮询该会话;禁止使用 shell 后台任务,禁止给任何流水线命令添加 `| tail`、`| tee`、`|| true` 或其他会掩盖退出码的包装。 4. `login` 是可见浏览器命令,必须严格按本技能给出的参数执行,不得添加 `--headed` 或其他未列出的参数。精确命令尚未失败时,不得先检查 CLI 帮助、源码或浏览器环境;精确命令失败后只按错误与 `capture-recovery.json` 恢复。 5. 未看到 `login` 成功、可提问页面已建立或 `results.json` 全平台成功证据前,禁止告诉用户“浏览器已启动”“采集已在后台运行”或“将自动进入后续流程”。 6. `login` 或 `run` 运行期间出现登录、短信验证码、人机验证或 CAPTCHA 时,保持命令和当前 Playwright 页面运行,立即提示用户本人处理;检测到处理完成后自动继续,不得关闭页面、重输问题或提前结束任务。 7. `login` 或 `run` 非零退出、浏览器意外关闭、人工处理超时或采集失败时,立即读取 `capture-recovery.json`,主动调用宿主浏览器工具或 Computer Use 恢复。两者都不可用时才说明能力缺失并停在原始答案采集阶段。 8. 进入恢复后,禁止改用 headless/无头浏览器、清理锁文件或修改启动参数规避接管。先读取 `captureLifecycle`:只要 `submissionAttempted`、`submissionConfirmed` 或 `answerObserved` 为真,就禁止重新填入、提交或询问同一问题,只能恢复原会话并继续等待、定位或提取现有回答。只有 `resubmissionAllowed=true` 时才可提交一次。选择器候选必须经过程序的唯一、可见、可编辑或非进度文本门禁;模型、Computer Use 和 `agent-browser` 都只能提议,不能直接采用或写回适配器。 9. `capture-gate.json` 未证明所有指定平台均成功前,禁止进入知识点对比和后续流程。不得用已有材料、搜索结果、空回答或部分成功结果替代失败平台。 10. **分阶段交付门禁**:原始答案采集、知识点对比和权威证据核验各自完成后,必须先向用户发送本阶段真实可打开的独立产物,再询问用户选择“继续下一步”“修正当前结果”或“到此结束并保留产物”。程序会在 `stage-checkpoints.json` 记录产物摘要和一次性确认令牌;收到用户“继续下一步”后,必须用 `acknowledge-stage --decision continue` 提交该令牌,否则下一阶段命令会直接失败。即使用户最初要求完整连续执行,也不能跳过阶段产物展示和用户确认。内部证据不足状态属于可交付边界,面向用户统一显示为“疑似误导”,不阻断后续报告。 本技能是对外唯一入口,包内自带三个独立业务模块: 1. `llm-answer-reference-compare`:多端回答、原始引用与现场存证无损采集。 2. `fact-check-x-knowledge-compare`:原子知识点拆解、主张对齐、来源忠实性判断。 3. `fact-check-x-authoritative-verify`:逐知识点可信搜索、证据裁决、独立权威核验报告与最终平台表现报告。 脚本只负责采集、校验、编排和渲染。知识点拆解、证据理解与裁决由当前运行载体完成,禁止调用任何外部模型 API。 所有面向用户的提示、阶段检查点、错误说明和最终答复必须使用中文。不得因为运行载体的默认语言改用英文。 ## 首次运行 先定位包内模块并自动准备采集运行时: ```bash python3 scripts/fact_check_x.py locate python3 scripts/fact_check_x.py prepare-runtime ``` `prepare-runtime` 的返回里带 `installedVersion`,是**当前实际运行的这份技能包**的版本与读取路径。 载体界面显示的可能是应用市场上的可用版本而不是本机已装版本,二者不一致时以这里为准; 向用户或群里反馈问题时先报这个版本号,避免把版本没装上误判成功能缺陷。 `prepare-runtime` 会先自检;依赖完整时直接跳过,首次缺失时根据包内锁文件自动执行 `npm ci --omit=dev`,并在实际调用采集 CLI 验证通过后才返回。不得借用其他技能目录或 旧安装残留的 `node_modules`,也不要求用户手工进入目录安装依赖。 正常在线采集直接使用系统 Chromium 浏览器,不要求下载 Chrome for Testing。 只有无头/CI 回归确有需要时才单独安装 Playwright 测试浏览器。 macOS 可见登录与交互采集按以下顺序自动选择系统浏览器:用户通过 `FACT_CHECK_X_BROWSER_EXECUTABLE` 指定的 Chromium 浏览器、Google Chrome、 Microsoft Edge、Brave、Chromium。Playwright 自带的 Chrome for Testing 默认只用于无头/CI 回归。系统没有上述浏览器时,使用 Computer Use 或提示用户 安装任一受支持浏览器;不得反复启动 Chrome for Testing。 ## 完整流程 ### 第一步:各方答案汇总 首次采集某个平台时,必须先在对话中告诉用户“将打开浏览器,请完成登录;检测到可提问界面后自动保存会话”。不得把提示只藏在命令输出里。然后逐个平台打开可见浏览器并等待登录准备命令成功: ```bash node modules/llm-answer-reference-compare/assets/tool/dist/cli.js login \ --platform dknowc-chat \ --question "<用户原始问题>" \ --out <run目录>/capture node modules/llm-answer-reference-compare/assets/tool/dist/cli.js login \ --platform doubao \ --question "<用户原始问题>" \ --out <run目录>/capture ``` 不得代替用户填写账号、密码、短信验证码或处理人机验证。登录会话只保存在 `~/.fact-check-x/browser-profiles`,不得写入技能包、任务产物或报告。已有持久化会话可以减少用户登录操作,但不能跳过载体能力预检、前台执行和可见页面成功验证。 豆包未登录页面也可能显示输入框。不得用“找到输入框”代替登录确认:豆包右上角登录入口仍可见时,只提示并等待用户完成登录,禁止填入或提交核验问题;登录入口消失并检测到可提问界面后才开始采集。 ```bash node modules/llm-answer-reference-compare/assets/tool/dist/cli.js run \ --question "<用户原始问题>" \ --platform dknowc-chat \ --platform doubao \ --out <run目录>/capture \ --headed \ --interactive \ --timeout 180000 \ --retries 2 ```
From ASI2030/Fact-Check-X, Apache-2.0.
More from ASI2030/Fact-Check-X
- 0.611score
fact-check-x-authoritative-verify
ASI2030
对单个知识点调用可信搜索取得官方证据,由当前运行载体裁决各平台主张,并分别生成权威核验后的最终答案与各方答案测评报告。支持多知识点独立并发、深知晓官方材料锚点免重复检索,以及直接准确、间接准确、结果巧合、严重误导、凭空编造等分类。可用于 Fact-Check-X 完整流程,也可作为独立的权威证据核验能力使用。
SkillAFreshness: A★ 4Claude Code +9 - 0.611score
llm-answer-reference-compare
ASI2030
用 Playwright 从深知晓、深知晓(深度溯源)、豆包、腾讯元宝、DeepSeek 和通义千问网页端无损采集完整回答、原始引用、引用标记和现场存证。用于 Fact-Check-X 的原始答案采集阶段,或任何需要比较多个 AI 网页回答与参考来源的任务。
SkillAFreshness: A★ 4Claude Code +9 - 0.608score
fact-check-x-knowledge-compare
ASI2030
在本地把多个 AI 原始回答拆成原子知识点,区分直接答案与补充参考,对齐各平台主张、差异、所附依据和来源忠实性,并生成可视化中间报告。不调用可信搜索或任何外部模型 API,语义分析由当前运行载体完成。
SkillAFreshness: A★ 4Claude Code +9 - 0.608score
fact-check-x-unified
ASI2030
Fact-Check-X 流程编排能力,依次组织各方答案汇总、各方答案聚合(未核验)、权威核验后的最终答案和各方答案测评,生成可打开、可审计、可迁移的阶段产物与完整报告包。
SkillAFreshness: A★ 4Claude Code +9
Signals
- Stars
- 4
- Forks
- 0
- Open issues
- 0
- Last commit (this folder)
- Oct 19, 2026 (12 days ago)
- Last release
- Oct 19, 2026 (12 days ago)
From GitHub (fetched Oct 24, 2026).
Details
- Version
- 1.1.25
- License
- Apache-2.0
- Repository
- github.com/ASI2030/Fact-Check-X
- First seen
- Oct 24, 2026
- Last checked
- Oct 24, 2026
- Source
- GitHubgithub-graphql
More from ASI2030
- 0.611score
fact-check-x-authoritative-verify
ASI2030
对单个知识点调用可信搜索取得官方证据,由当前运行载体裁决各平台主张,并分别生成权威核验后的最终答案与各方答案测评报告。支持多知识点独立并发、深知晓官方材料锚点免重复检索,以及直接准确、间接准确、结果巧合、严重误导、凭空编造等分类。可用于 Fact-Check-X 完整流程,也可作为独立的权威证据核验能力使用。
SkillAFreshness: A★ 4Claude Code +9 - 0.611score
llm-answer-reference-compare
ASI2030
用 Playwright 从深知晓、深知晓(深度溯源)、豆包、腾讯元宝、DeepSeek 和通义千问网页端无损采集完整回答、原始引用、引用标记和现场存证。用于 Fact-Check-X 的原始答案采集阶段,或任何需要比较多个 AI 网页回答与参考来源的任务。
SkillAFreshness: A★ 4Claude Code +9 - 0.608score
fact-check-x-knowledge-compare
ASI2030
在本地把多个 AI 原始回答拆成原子知识点,区分直接答案与补充参考,对齐各平台主张、差异、所附依据和来源忠实性,并生成可视化中间报告。不调用可信搜索或任何外部模型 API,语义分析由当前运行载体完成。
SkillAFreshness: A★ 4Claude Code +9 - 0.608score
fact-check-x-unified
ASI2030
Fact-Check-X 流程编排能力,依次组织各方答案汇总、各方答案聚合(未核验)、权威核验后的最终答案和各方答案测评,生成可打开、可审计、可迁移的阶段产物与完整报告包。
SkillAFreshness: A★ 4Claude Code +9
Done for you
Rather not set it up yourself?
Chalk Labs scopes, builds and runs agents for your team: the task audit, the eval harness, the integrations and the weekly ops report. Fixed scope, priced before we start.
See how we build AI agents →Read the case studies
Chalk Labs is a two-founder AI and growth studio. We build AI agents, CRMs and MVPs for Web3 and AI companies, and have shipped 50+ product and token launches.
- launches shipped
- 50+
- launches shipped
- media placements
- 500+
- media placements
- founders on every account
- 2
- founders on every account
Press we've placed: Forbes · CoinDesk · Decrypt · Cointelegraph · The Block
Rahil Jain, Co-founder, Chalk Labs. Ex-Goldman Sachs engineer. You talk to the person who builds it.
Get fact-check-x-complete running in your business
Tell us what you want to automate. A founder replies within one working day with a plan, not a pitch deck.
Cite this page
fact-check-x-complete skill. Agent Mart. https://agentmart.dev/skills/asi2030-fact-check-x-complete (last updated 2026-10-24)